一、FIH剂量
起始剂量的选择本质上是一个“窗口问题”:必须低到足以保证受试者安全,又必须高到避免过度冗长的剂量递增——每一次递增都意味着更多的剂量队列、更长的周期、更高的成本。准确的临床前人体PK预测,平均可为剂量爬坡阶段节省1~6个月的开发时间。
没有哪一种方法被公认最准,目前的主流做法是“多法并算、交叉验证”。归纳为五大流派:
| 方法 | 核心思路 | 优势 | 局限 |
| NOAEL法 | 动物NOAEL按体表面积换算人体等效剂量(HED),除以安全因子得MRSD | 小分子药物安全性记录良好,简单实用 | 安全因子偏经验、整体保守;忽视药理学活性剂量与种属间药效学差异 |
| MABEL法 | 以产生任何生物学效应(毒性或预期药理作用)的最低剂量为起点 | 基于药理学知识而非经验因子,适用于生物药与激动剂 | 需要大量机制数据(靶点结合、受体占用、暴露-响应) |
| 类似药物比较法 | 借用结构类似、已有临床数据药物的剂量按NOAEL比值折算 | 简单,所需数据极少 | 仅适用于极少数有“孪生”药物的候选分子 |
| PK导向法 | 预测人体清除率与生物利用度,反推达到目标暴露所需的剂量 | 基于药代动力学性质而非经验因子,机制性更强 | 忽视种属间药效学差异;依赖人体PK预测的准确性 |
| PK/PD建模法 | 整合暴露-响应关系的数学模型,模拟人体剂量-暴露-响应-时间全过程 | 同时考虑PK与PD的种属差异,减少对经验安全因子的依赖 | 建模与验证工作量大 |
表 五种FIH剂量估算方法对比
1. NOAEL法
2005年7月,FDA发布行业指南《Estimating the Maximum Safe Starting Dose in Initial Clinical Trials for Therapeutics in Adult Healthy Volunteers》,确立了如下流程:①确定各动物种属的NOAEL → ②按体表面积换算为HED → ③选择最敏感种属的最低HED → ④除以安全因子(一般不低于10)得到人体最大推荐起始剂量(MRSD)→⑤必要时还需根据药理学活性剂量(PAD)向下调整。
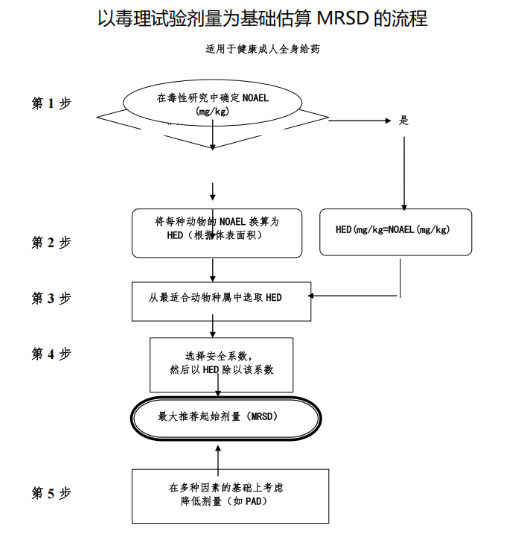
图1:以毒理试验剂量为基础估算 MRSD 的流程[2]
一个简单的计算示例:
| 步骤 | 内容 | 结果 |
| Step 1 | 大鼠 NOAEL 50 mg/kg;犬 NOAEL 15 mg/kg | — |
| Step 2 | 使用体表面积法将NOAEL换算至HED:大鼠HED = 50÷(36.88/6.04)≈8.2 mg/kg;犬 HED = 15÷(36.88/21.47)≈8.7 mg/kg | — |
| Step 3 | 大鼠换算得到的 HED 更低,默认选择大鼠来源数据 | HED=8.2 mg/kg |
| Step 4 | 无特殊风险信号,安全系数 SF 取默认值 10 | MRSD=8.2÷10=0.82 mg/kg |
| Step 5 | 假设药理学 HED 为 5 mg/kg,大于 0.82 mg/kg,无需进一步下调剂量 | 最终MRSD≈0.82 mg/kg |
一个常被忽视的细节:换算基准的选择会剧烈影响结果。若小鼠、大鼠、犬改按体重而非体表面积换算,HED将分别被放大12倍、6倍和2倍。指南之所以选择体表面积,正是为了保守。
但TGN1412事件暴露了NOAEL法的根本盲区——它回答的是“动物没出事的剂量”,而不是“人体开始起效的剂量”。当药物的药效学敏感性存在巨大种属差异(比如TGN1412靶向的CD28通路,人类T细胞的应答远比猴敏感)时,再大的安全系数也可能失灵。
2. MABEL法
TGN1412事件后,欧洲药品管理局(原EMEA,现EMA)于2007年发布FIH试验风险管理指南,引入MABEL(最低预期生物效应水平)概念:以引起任何生物学效应——无论毒性还是预期药理作用——的最低剂量作为起点。其计算依托四类PK/PD数据:①靶点在人与动物细胞上的结合与受体占用;②体外浓度-效应曲线;③动物体内剂量-暴露-效应;④动物药理活性剂量下的暴露水平。
对于TGN1412,采用基于MABEL的方法估算的FIH剂量为0.001 mg/kg(31)。相比之下,采用基于 NOAEL 的方法估算的TGN1412的FIH剂量为0.1 mg/kg,这将导致受体占据率超过90%,极可能导致不良反应。
对于作用于关键生理系统的激动型生物药,指南建议首次给药的受体占用不超过10%。EMA强烈推荐同时计算NOAEL法与MABEL法结果,科学论证后选择更低安全起始剂量。MABEL法在后续的生物药开发中已成为标准操作。
3. PK导向法
Dose = (CLhuman × AUCanimal) / Fhuman
起始口服剂量 = 预测人体清除率 × 指示动物NOAEL暴露量(AUC)÷ 预测人体口服生物利用度;亦可用 Css 或 Cmax 替代AUC作为目标暴露指标
具体操作中,先在多个动物种属中确定NOAEL及对应AUC,选择NOAEL最低的种属作为“指示动物”;Mahmood等人则建议选择清除率(按千克体重)与预测人体值最接近的种属,再以动物CL与人体预测CL之比作为校正因子。Collins等人将此法用于3个抗肿瘤药,每个药的I期试验缩短了12~24个月——这正是PK导向法的核心吸引力:合理的人体剂量预估可以直接砍掉多个剂量爬坡队列。
但它有两个内嵌假设:①只有原形药有活性;②相同血药浓度下,药物在人与其他种属中产生相同的药理/毒理效应。第二个假设恰恰在TGN1412这类种属敏感性差异巨大的场景下失效。
4. PK/PD建模法
Lowe等人提出的四步法是目前公认的系统化框架:
- 通过体外/体内药理实验建立浓度-效应关系,确定生物标志物与PD参数(如EC50);
- 刻画种属差异——组织分布、组织/血浆蛋白结合、血细胞结合、靶受体占用的差异;
- 预测人体PK参数(CL、F、血药浓度-时间曲线);
- 整合人体PK与PD模型,模拟剂量-暴露-响应-时间过程:简单情形用阈值模型(浓度维持在EC50之上、毒性阈值之下),复杂情形用完整PK/PD仿真。
Heimbach等人进一步把制剂与生物药剂学参数(如BCS分类)纳入模型,使不同剂型、不同溶解特性药物的PK/PD投影成为可能,并证明仅用单一种属数据即可完成人体PK/PD投影。对于药代行为高度可预测的单克隆抗体(PK性质由亚型决定、均一性好),PK/PD建模尤其成功;以可体外测定的受体占用(RO)为生物标志物时,激动剂起始剂量取低RO、拮抗剂可取高RO。
二、17种人体清除率预测方法
PK/PD导向方法的精度,最终取决于能否准确预测两个关键PK参数:清除率(CL)和生物利用度(F)。17种清除率预测方法分属三大门派:种属间异速放大(经验派)、体外-体内外推(IVIVE)(机制派)与计算机预测(数据派)。
门派一:异速放大——“动物即小号人类”
①简单异速放大。异速放大的底层信念是:解剖与生理功能在哺乳动物间遵循相似的规模法则。最基础的形式是简单异速放大(SA):
CL = a × W^b
W为体重,a为系数,b为指数;至少需要两种动物的数据拟合
SA的适用性高度依赖药物的肝脏提取率。对高提取率药物,肝清除率受肝血流限制,而肝血流恰与体重跨种属相关,因此预测较准。Tang等对57个肝消除药物的全景分析显示:预测精度呈高CL(n=11)>中CL(n=17)>低CL(n=29)的梯度。对治疗性蛋白(n=10),SA的可靠性也显著优于小分子(n=102)。一个重要的方法论教训:多数异速放大研究喜欢报告决定系数r²来展示拟合优度,但Tang与Mayersohn用数学模型和文献数据证明——r²与人体CL预测准确性之间并无相关关系。曲线拟合得好,不等于外推得准。
② 游离型CL换算。由于血浆蛋白结合存在显著种属差异、且只有游离型药物才能被消除,对游离CL(CLu)做异速放大理论上更合理。Obach等对14个药物的回顾分析:总CL预测平均倍数误差(AFE)1.91、64%落在两倍误差内;游离CL则为AFE 1.79、69%——改善真实但幅度有限。另一项24个化合物的研究对比更悬殊:SA仅17%落在两倍误差内,游离CL法则达62%。不过若以30%误差为成功线,两者无显著差异,判定标准的选择对于评估不同方法的可预测性至关重要。
③二项式幂方程。针对低肝提取药物(其CL与体重不相关),Boxenbaum &Fertig将人体CL与脑重量(BrW)、最大寿命潜能(MLP)关联;或以CL×MLP与体重做异速放大。相关预测研究较少,不常用。
④ 指数法则(RoE)。Mahmood与Balian基于50个药物(≥3种属)的数据,根据SA指数b的大小引入脑重(BrW)或最大寿命潜能(MLP)校正。原始验证中,45个药物有42个落在两倍误差内,优于SA的35/45。后续68个化合物的研究也支持RoE优于其他异速方法、与IVIVE相当(尤其对低脂溶性、中高清除率化合物)。但Nagilla与Ward用103个化合物的大数据集发现所有校正因子(BrW、MLP、GFR、UDPGT、胆汁流率)都不能改善预测——RoE的性能存疑,可能高度依赖数据集构成。
⑤ 肾/胆排泄药物的校正放大。肾脏清除涉及滤过、重吸收与主动分泌三种机制,SA对高肾清除药物常常失灵。Mahmood提出以GFR、肾血流量、肾重或肾重量为校正因子;对胆汁排泄药物则以胆汁流率或UDPGT酶活性校正。两个数据集虽小(n=8和n=10),但均显示优于SA和RoE。肠肝循环药物仍是预测的硬骨头——种属间肝胆转运体表达的差异所知甚少。
⑥ 体外固有清除率归一化。Lave等用动物与人的体外固有CL校正动物体内CL后再做异速放大,11个肝消除药物中9个(82%)落在两倍误差内,平均折叠误差AFE为 1.6倍。
⑦ 多指数异速(MA)。为消除“选哪个校正因子”的不确定性,Goteti等假设CL同时关联体重与消除器官(肝、肾)体积:CL = a×W^b + c×W^d,其中器官体积对体重的斜率约为0.9,故d固定为0.9。训练集76%两倍内误差;测试集54%两倍内误差——优于SA、略逊于RoE;但当SA指数b<0.7时,SA反而更准。
⑧ 肝血流法(LBF)。用种属间肝血流比值直接外推。Ward与Smith对103个药物的综合评估:猴LBF法是最准的单项方法(72%两倍内),优于三物种及两物种的各种异速放大(62%~66%),也优于大鼠LBF和犬LBF(均为66%)。后续研究进一步发现小鼠与猴LBF优于大鼠与犬LBF。
⑨ 一/两种属外推。Tang等基于102个药物的数据库,直接给出了从单一物种(大鼠、犬或猴)或两物种组合外推人的固定系数经验方程(如CLhuman = 0.152×CLrat,0.410×CLdog,0.407×CLmonkey,单位均为kg规格)。在26个化合物的测试集中,性能至少与RoE/SA相当。但Mahmood用45个药物的数据提出异议——RoE仍更优。争议的亮点在UGT代谢酶底物:12个UGT药物的对比中,猴单种属外推(固定指数0.75)优于RoE。
⑩ 垂直异速与FCIM。部分化合物经异速放大后人体CL被严重高估(可达数十倍),称为“垂直异速”。Tang与Mayersohn给出了识别标准:ClogP>2、大鼠与人血浆游离分数之比Rfu>5、经代谢消除。识别之后进一步建立了fu校正截距法(FCIM):
CL = 33.35mL/min × (a / Rfu)^0.77
a为SA系数,Rfu为大鼠/人血浆游离分数比
实用策略:SA指数b<0.5或b>1.2时用FCIM,0.5<b<1.2时用游离CL法,两倍误差率可达79%。
门派二:IVIVE——从试管直接外推到人体
① 基于生理学放大因子(PB-SF)的经典IVIVE。IVIVE的哲学完全不同:不依赖动物体内数据,而是用人源体外系统(肝微粒体、肝细胞、重组CYP450酶)测得固有清除率,再用生理学放大因子换算肝脏清除率(CLH):
- 生理学放大因子(PB-SF):每千克体重3.1×10⁹个肝细胞(1.2×10⁸细胞/克 肝×25.7克肝/千克 体重)或1028 mg肝微粒体;
- 肝处置模型:well-stirred(充分搅拌,因计算简便最常用)、parallel tube(并行管)、dispersion(弥散)——后两者预测精度相近且均优于well-stirred;高清除率药物以dispersion模型最可靠。
然而“裸”IVIVE有一个著名的系统性问题:低预测。Ito与Houston用肝微粒体数据预测55个化合物,CLint, in vivo平均被低估9倍;Brown等用肝细胞数据,仍平均低估4.5倍。Chiba等总结了四个原因:体外组织制备与储存过程损失代谢活性;肝外代谢(肠、肾)贡献被忽略;药物与微粒体脂质/细胞成分的非特异性结合未校正;肝摄取转运体介导的清除被低估——转运体底物的低估尤其严重。由此衍生出一系列校正策略:
②药物特异性放大因子校正的IVIVE。用同一药物在动物体内的CLint,in vivo / CLint,in vitro比值作为校正。Ito与Houston(33个化合物,大鼠)将AFE从6.17降到2.33,两倍内命中率从15.2%升至39.4%;Naritomi等(8个药物,大鼠/犬因子)将AFE从4.02降至1.57/1.68,两倍内命中率从25%跃升至69%/77%。
③经验放大因子校正的IVIVE。不用动物实验,直接回归人CLint,in vivo与CLint,in vitro得到平均系数。Lave等将其纳入后,两倍内命中率从15.2%升至45.5%(n=33);Zuegge等报告AFE从2.01降至1.64、三倍内命中率从77.3%升至95.5%。Fagerholm进一步按药物类别(酸/碱/中性×低/高CLint)分组建立类别特异性因子(CD-SF),达到AFE 1.3、两倍内76%(n=29)。
④蛋白结合校正的IVIVE。只有游离药物才能被代谢,因此纳入血浆游离分数fu,p、微粒体游离分数fu,micro或肝细胞游离分数fu,hepa。Obach对29个化合物的经典分析给出了精细的结论:碱性和中性化合物仅校正fu,p反而预测变差,需同时校正fu,p与fu,micro;酸性化合物则必须双重校正才可靠。另一巧妙做法:在微粒体孵育液中直接加入人血浆,两倍内命中率从57%提高到71%。
⑤重组酶(单个代谢酶)IVIVE。用重组人CYP450酶替代肝微粒体/肝细胞,通过相对丰度法(按免疫定量蛋白水平加权)或相对活性因子法(RAF)整合各同工酶贡献。Stringer等对72个药物的评估:重组酶AFE 1.53,显著优于肝微粒体(AFE 2.32, n=41)和肝细胞(AFE 5.21, n=57)。
⑥肾清除率的生理学预测法。上述IVIVE均不适用于肾排泄药物。Fagerholm基于体外被动渗透性(Pe)建立渗透性分类系统,用GFR、肾血流量、fu,p、重吸收分数推算肾清除,但尚未经大规模数据集验证。
门派三:计算机预测——分子结构直通人体CL
纯in silico方法(MLR多元线性回归、PLS偏最小二乘、ANN人工神经网络、kNN k近邻)只需分子描述符即可预测,能在化合物未合成之前完成虚拟筛选——这是所有实验方法做不到的。Wajima等用大鼠/犬CL、分子量、ClogP、氢键受体数建立的MLR方程声称优于异速放大,但被Mahmood指出训练集与评估集是同一批数据,属于循环论证。Yu建立的kNN模型(370个化合物训练、92个测试)测试集平均落在两倍误差内,用于文献中20个药物时逊于RoE、优于SA。总体而言,这类“黑箱”方法适合早期高通量粗筛,不能作为FIH剂量决策的独立依据。
三、生物利用度预测
口服是最受青睐的给药途径,但大量候选分子恰恰倒在生物利用度这一关。生物利用度可拆解为三个环节的乘积:
F = FA × FG × FH
FA:吸收分数;FG:逃过肠道首过代谢的分数;FH:逃过肝脏首过代谢的分数(FH = 1 − CLH/QH)
由于肠道CYP酶含量低、肠道血流量小,肠道代谢一般可忽略——但对结合反应底物(硫酸化/葡萄糖醛酸化)与CYP3A4底物例外,FG可能成为决定性瓶颈。盘点了6类预测工具:
体外三件套:Caco-2、PAMPA、IAM
① Caco-2单分子层。人结肠腺癌细胞在跨孔膜上长成致密单层,测得表观渗透系数Papp。Artursson与Karlsson的经典研究显示其与人体肠道吸收高度相关(n=35,r=0.95),并有经验方程:FA% = 1.95×ln(Papp) + 24.4。短板:主动转运体在Caco-2中表达失常,无法可靠预测主动转运药物的吸收。
② PAMPA(平行人工膜渗透)。仿肠道刷状缘膜脂质组成的滤膜支撑人工膜系统,与Caco-2的FA预测精度相当,但通量更高、成本更低;同样只能评估被动跨细胞渗透,对旁路转运和主动转运无能为力。
③ IAM色谱。硅胶粒表面共价接枝磷脂单层,模拟细胞膜脂环境,以容量因子K′IAM与吸收分数建立定量关系。定位与PAMPA类似。
体内方法
这是文献中极具警示意义的一组数据:Cao等发现大鼠与人小肠药物渗透性相关性良好(r²=0.8),但口服生物利用度几乎无关(r²=0.29)——罪魁是肠道代谢酶表达的种属差异。Akabane等进一步发现,13个受试化合物中有8个在猴体内的生物利用度显著低于人体,因为猴的肠道代谢更强。结论:动物模型可以估计“吸收”,但“吸收×首过代谢”的乘积,别指望动物。
计算机模型
- QSBR模型(Andrews等):591个药物×82个子结构描述符的逐步回归,预测人口服生物利用度优于Lipinski类药五规则(最早的口服吸收定性模型),且能指出影响F的关键子结构、反哺药物设计;Yoshida等的有序多分类QSAR在232个药物上正确率71%,对40个外部药物预测准确率60%;
- PBPK模型:从弥散模型、房室模型吸收与转运(CAT)到高级房室吸收与转运(ACAT)模型(9个胃肠节段的生理模型,可描述释放、溶解、降解、代谢、摄取、吸收全过程),已形成GastroPlus™、PKSim®、IDEA™、Simcyp®等商业化软件生态。
四、药时曲线预测
FIH剂量设计真正关心的,是给药后的AUC、消除半衰期、峰谷浓度比——既要保证暴露量足够有效,又要靠Cmax和Cmin的预判来规避毒性、维持有效浓度。总结为三种曲线级预测工具:
① 种属不变时间法(Dedrick图)
源于异速放大思想:把浓度轴按剂量或体重归一、把实际时间变换为生理时间(以心跳数/呼吸数定义),不同种属的血药浓度曲线理论上可以叠加,再反变换回人体。
② Css–MRT法
Wajima等提出:将时间轴除以平均滞留时间(MRT)、浓度轴除以稳态浓度(Css = 剂量/Vd,ss),各动物种属的药时曲线可以良好叠加——这规避了Dedrick图中曲线叠加不佳的问题。再用预测的人体Css与MRT反变换,即得人体静脉曲线;结合吸收速率常数与生物利用度可进一步模拟口服曲线。
③ PBPK模型
PBPK模型将人体拆分为肺、脾、肝、肠、脂肪、肌肉、心、脑、肾、皮肤、红/黄骨髓等多个组织室,以血液循环串联,假设药物在各室内瞬间均匀分布、摄取受血流/扩散限制。组织-血浆分配系数Kp可用组织组成模型(Poulin–Theil、Berezhkovskiy、Rodgers等方程)预测;CLH由IVIVE或异速放大而来,CLR由异速放大或GFR比值法估计;口服吸收用GastroPlus™(ACAT模型)等软件模拟。
五、结语
回到最初的问题:第一次人体给药的剂量怎么定?——没有任何一种方法能在所有场景下胜出,剂量估算的每一次进步,都来自生理机制的更深理解与多源证据的更严整合,而不是某一个漂亮公式的横空出世。对从业者的启示或许正是如此:把每一个预测都当作假设,把每一针起始剂量都当作需要全数据链辩护的决策。
参考文献
- Zou P, Yu Y, Zheng N, Yang Y, Paholak HJ, Yu LX, Sun D. Applications of Human Pharmacokinetic Prediction in First-in-Human Dose Estimation. The AAPS Journal, 2012, 14(2): 262–281.
- 国家食品药品监督管理局药品审评中心。健康成年志愿者首次临床试验药物最大推荐起始剂量的估算指导原则 [S]. 北京:国家食品药品监督管理局,2012.
撰文:聂茹佳 秦雨
审核:宫雪